Triton Inference ejecuta modelos de IA en apps

En el acelerado mundo de la inteligencia artificial, ejecutar modelos de manera eficiente dentro de aplicaciones es un desafío clave. Triton Inference surge como una solución diseñada para optimizar este proceso, permitiendo a los desarrolladores integrar modelos de IA en entornos de producción con mayor facilidad. Su arquitectura flexible y escalable lo convierte en una herramienta esencial para empresas que buscan desplegar inferencias rápidas y confiables.
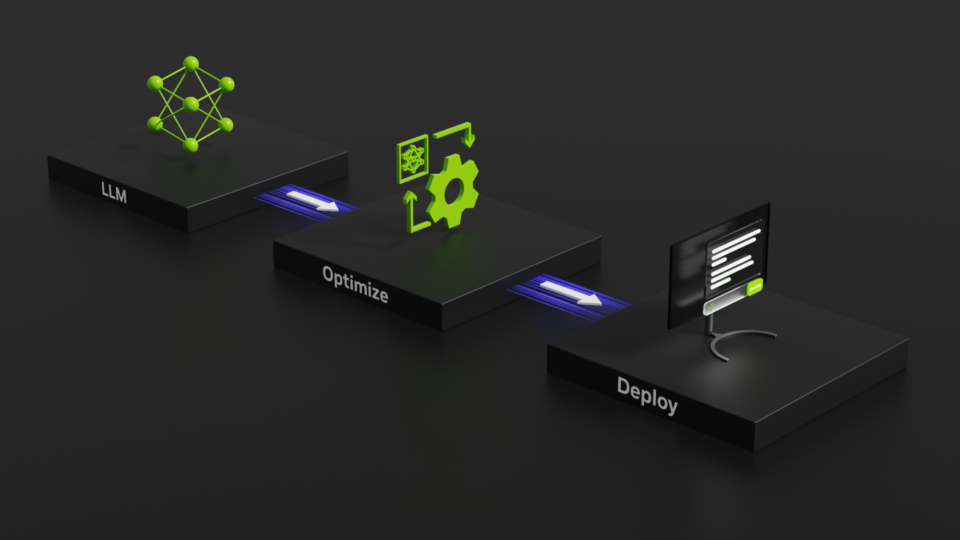
La plataforma soporta una amplia variedad de frameworks de aprendizaje automático, facilitando la implementación de modelos complejos sin sacrificar rendimiento. Triton Inference no solo reduce la latencia, sino que también simplifica la gestión de recursos, adaptándose a cargas de trabajo dinámicas. Con su capacidad para operar en entornos locales o en la nube, se posiciona como una opción versátil para equipos que necesitan escalabilidad y eficiencia en sus aplicaciones impulsadas por IA.
Te puede interesar leer: MusicVibe genera música con IA para creadores
¿Cómo Triton Inference optimiza la ejecución de modelos de IA en aplicaciones?
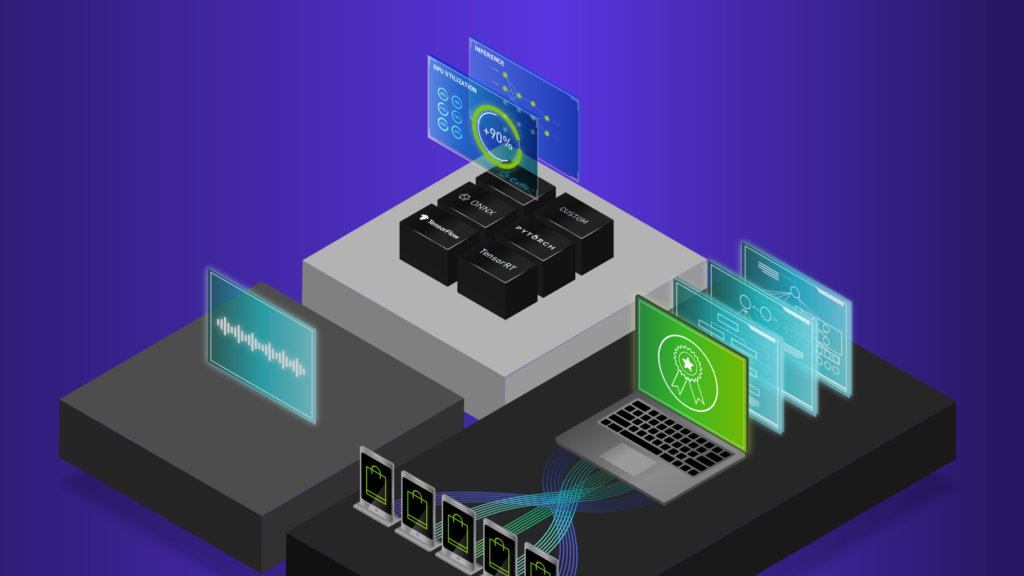
Triton Inference Server es una plataforma de código abierto desarrollada por NVIDIA que permite desplegar, ejecutar y escalar modelos de aprendizaje automático en entornos de producción. Su arquitectura está diseñada para ofrecer baja latencia y alto rendimiento, lo que lo convierte en una solución ideal para aplicaciones que requieren inferencia de IA en tiempo real. Además, es compatible con múltiples frameworks como TensorFlow, PyTorch y ONNX, facilitando la integración en diversos proyectos.
Ventajas de usar Triton Inference en aplicaciones
Triton Inference Server proporciona beneficios clave para desarrolladores y empresas que buscan implementar modelos de IA de manera eficiente: - Escalabilidad: Permite servir múltiples modelos simultáneamente, optimizando el uso de recursos. - Flexibilidad: Soporta una amplia variedad de frameworks y backends de hardware. - Rendimiento: Reduce la latencia mediante técnicas como el batch dinámico y la concurrencia optimizada.
| Característica | Beneficio |
|---|---|
| Batch dinámico | Mejora el throughput al agrupar solicitudes de inferencia |
| Multi-framework | Integración sencilla con TensorFlow, PyTorch, etc. |
| Escalado horizontal | Distribuye carga en múltiples GPUs/CPUs |
Casos de uso de Triton Inference en la industria
Esta tecnología es utilizada en sectores como: - Salud: Diagnóstico médico mediante modelos de visión por computadora. - Automoción: Procesamiento de datos de sensores en vehículos autónomos. - Retail: Recomendaciones personalizadas en tiempo real. La capacidad de Triton para manejar cargas de trabajo complejas lo hace indispensable en entornos de producción.
| Industria | Aplicación |
|---|---|
| Salud | Análisis de imágenes radiológicas |
| Finanzas | Detección de fraudes con IA |
| Manufactura | Control de calidad automatizado |
Configuración básica de Triton Inference Server
Para implementar Triton en una aplicación, se deben seguir pasos clave: 1. Instalación: Utilizar contenedores Docker para simplificar el despliegue. 2. Model Repository: Organizar los modelos en una estructura específica. 3. Optimización: Ajustar parámetros como el tamaño de batch y la concurrencia. La configuración correcta asegura un rendimiento óptimo en entornos de producción.
| Paso | Descripción |
|---|---|
| 1. Despliegue | Usar Docker o Kubernetes para la implementación |
| 2. Modelado | Configurar el repositorio de modelos |
| 3. Monitoreo | Integrar herramientas para seguimiento del rendimiento |
Mas Información sobre este tema
¿Qué es Triton Inference y cómo ayuda a ejecutar modelos de IA en aplicaciones?
Triton Inference es un servidor de inferencia de código abierto desarrollado por NVIDIA, diseñado para ejecutar modelos de IA de manera eficiente en entornos de producción. Su principal ventaja radica en su capacidad para optimizar el rendimiento de inferencia, permitiendo a las aplicaciones procesar solicitudes de machine learning a gran escala con baja latencia. Triton soporta múltiples frameworks como TensorFlow, PyTorch y ONNX, lo que facilita la integración en aplicaciones existentes sin necesidad de cambios significativos en la infraestructura.
¿Qué tipos de modelos de IA son compatibles con Triton Inference?
Triton Inference es compatible con una amplia variedad de modelos de IA, incluyendo aquellos basados en redes neuronales profundas, modelos de visión por computadora, procesamiento de lenguaje natural (NLP) y recomendación. Además, soporta formatos como TensorRT, lo que permite acelerar la inferencia en hardware NVIDIA. Su arquitectura flexible también admite modelos personalizados, lo que lo hace ideal para equipos que necesitan desplegar soluciones de IA específicas para sus aplicaciones.
¿Cómo mejora Triton Inference el rendimiento en aplicaciones que usan IA?
Triton Inference mejora el rendimiento mediante técnicas avanzadas como la ejecución concurrente de modelos, el uso eficiente de recursos GPU/CPU y la capacidad de manejar cargas de trabajo dinámicas. Además, ofrece funciones como el autoajuste de lotes (batching) y la priorización de solicitudes, lo que reduce la latencia y aumenta el throughput. Estas optimizaciones son clave para aplicaciones que requieren respuestas en tiempo real, como chatbots, sistemas de reconocimiento de imágenes o análisis de datos masivos.
Si quieres conocer otros artículos parecidos a Triton Inference ejecuta modelos de IA en apps puedes visitar la categoría IA para Desarrolladores.
Deja una respuesta
Contenido Relacionado