HorovodRunner ejecuta IA distribuida en Spark
HorovodRunner ejecuta IA distribuida en Spark, en el mundo del aprendizaje automático y el procesamiento de datos a gran escala, la necesidad de ejecutar modelos de inteligencia artificial de manera distribuida se ha vuelto esencial. HorovodRunner emerge como una herramienta clave para aquellos que trabajan con Apache Spark, permitiendo la ejecución eficiente de cargas de trabajo de IA en entornos distribuidos. Su integración con Horovod, un marco de entrenamiento distribuido de código abierto, facilita el escalado horizontal de modelos complejos sin sacrificar rendimiento.
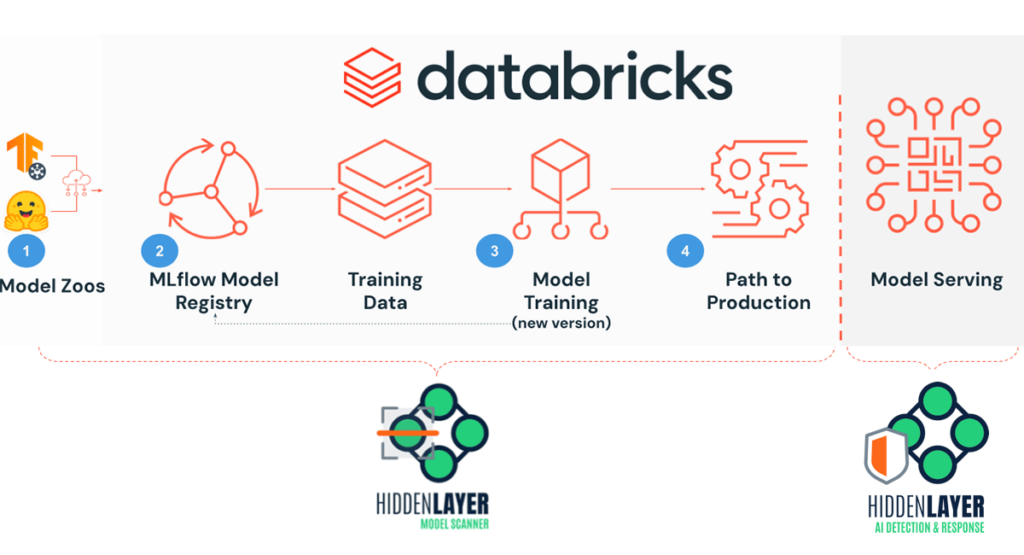
Esta tecnología es especialmente útil en escenarios donde los conjuntos de datos son masivos y los modelos requieren un alto poder computacional. Al aprovechar la infraestructura de Spark, HorovodRunner optimiza la asignación de recursos y reduce los tiempos de entrenamiento. Su capacidad para manejar tareas en paralelo lo convierte en una solución ideal para equipos que buscan acelerar el desarrollo de aplicaciones de IA sin comprometer la escalabilidad.
Te puede interesar leer: TaskWorld organiza tareas con inteligencia artificial
¿Cómo HorovodRunner facilita la ejecución de IA distribuida en Spark?
HorovodRunner es una herramienta clave para ejecutar cargas de trabajo de inteligencia artificial (IA) de manera distribuida en entornos Apache Spark. Esta biblioteca, desarrollada por Uber, permite escalar modelos de aprendizaje profundo utilizando el paradigma de procesamiento distribuido de Spark, lo que acelera el entrenamiento de modelos complejos al aprovechar múltiples nodos de un clúster. La integración de HorovodRunner con Spark simplifica la implementación de IA distribuida, reduciendo la complejidad de manejar comunicación entre nodos y optimizando el uso de recursos. Esto lo convierte en una solución ideal para equipos que ya utilizan Spark y desean incorporar capacidades avanzadas de IA sin cambiar su infraestructura.
Ventajas de usar HorovodRunner en Spark
HorovodRunner ofrece múltiples beneficios al ejecutar IA distribuida en Spark. Entre ellos destaca su capacidad para paralelizar el entrenamiento de modelos, permitiendo que grandes conjuntos de datos sean procesados en fracciones del tiempo que requeriría un enfoque tradicional. Además, su integración con frameworks populares como TensorFlow y PyTorch facilita la adopción sin necesidad de reescribir código existente. La escalabilidad automática y la gestión eficiente de recursos son otras ventajas clave.
| Ventaja | Impacto |
|---|---|
| Paralelización eficiente | Reduce tiempos de entrenamiento en modelos complejos |
| Compatibilidad con frameworks | Funciona con TensorFlow, PyTorch y otros sin modificaciones |
| Gestión de recursos | Optimiza el uso de CPU/GPU en el clúster Spark |
Configuración básica de HorovodRunner en Spark
Para implementar HorovodRunner en un entorno Spark, es necesario configurar adecuadamente el entorno de ejecución. Esto incluye la instalación de dependencias como Horovod, TensorFlow/PyTorch y las bibliotecas de soporte para Spark. La configuración del clúster debe permitir la comunicación entre nodos mediante MPI (Message Passing Interface), requisito fundamental para el funcionamiento distribuido. Una configuración típica implica definir el número de workers y asignar recursos específicos (CPU/GPU) a cada uno.
| Componente | Requisito |
|---|---|
| Entorno Spark | Versión compatible con HorovodRunner |
| Bibliotecas de IA | TensorFlow ≥ 2.0 o PyTorch ≥ 1.0 |
| Comunicación | MPI instalado en todos los nodos |
Casos de uso comunes para HorovodRunner
HorovodRunner es particularmente útil en escenarios donde se requiere procesar grandes volúmenes de datos con modelos complejos. Algunos casos típicos incluyen el entrenamiento de redes neuronales profundas para visión por computadora, procesamiento de lenguaje natural (NLP) y sistemas de recomendación a gran escala. Empresas con infraestructura Spark existente pueden aprovechar HorovodRunner para modernizar sus flujos de trabajo de IA sin incurrir en costos adicionales de infraestructura. También es ideal para proyectos que necesitan escalar rápidamente sin sacrificar rendimiento.
| Caso de uso | Beneficio |
|---|---|
| Visón por computadora | Entrenamiento rápido de CNN en grandes datasets |
| Procesamiento de lenguaje | Escalabilidad para modelos Transformer |
| Sistemas de recomendación | Procesamiento distribuido de matrices de interacción |
Mas Información sobre este tema
¿Qué es HorovodRunner y cómo facilita la ejecución distribuida de IA en Spark?
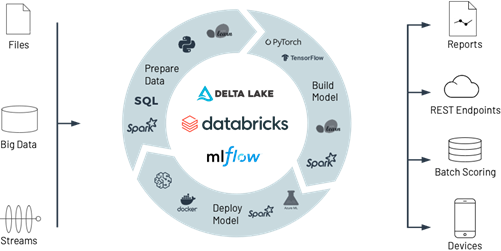
HorovodRunner es una herramienta diseñada para simplificar la ejecución de modelos de inteligencia artificial distribuidos en entornos Apache Spark. Permite escalar entrenamientos de deep learning utilizando el framework Horovod, optimizado para trabajar con clusters de Spark. Su principal ventaja es la capacidad de distribuir cargas de trabajo en múltiples nodos, acelerando el proceso de entrenamiento sin requerir cambios significativos en el código original. Esto lo hace ideal para proyectos que necesitan manejar grandes volúmenes de datos y modelos complejos.
¿Cuáles son los requisitos para usar HorovodRunner en un cluster de Spark?
Para utilizar HorovodRunner, es necesario contar con un cluster de Spark configurado correctamente, preferiblemente con una versión compatible (como Spark 2.4+). Además, se requiere instalar las bibliotecas de Horovod y sus dependencias, como TensorFlow o PyTorch, en todos los nodos del cluster. Es crucial asegurar que los nodos tengan acceso a los mismos datos, ya sea mediante un sistema de archivos compartido o soluciones como HDFS o Amazon S3. También se recomienda verificar la compatibilidad de las versiones de las bibliotecas para evitar errores durante la ejecución.
¿Cómo se compara HorovodRunner con otras soluciones de IA distribuida en Spark?
HorovodRunner destaca por su integración nativa con Spark y su capacidad para aprovechar las ventajas de Horovod, como la comunicación eficiente entre nodos mediante MPI (Message Passing Interface). A diferencia de otras soluciones, como Spark MLlib (más orientado a modelos tradicionales), HorovodRunner está optimizado para deep learning, ofreciendo mejor rendimiento en tareas complejas. Sin embargo, puede requerir más configuración inicial comparado con alternativas como TensorFlowOnSpark, pero su flexibilidad y escalabilidad lo hacen preferible en entornos de producción a gran escala.
Esto es de tu interes DeepSpeed optimiza entrenamiento de IA con PyTorch
 Megatron-LM entrena modelos de IA masivos
 Triton Inference ejecuta modelos de IA en apps
Si quieres conocer otros artículos parecidos a HorovodRunner ejecuta IA distribuida en Spark puedes visitar la categoría IA para Desarrolladores.
Deja una respuesta
Contenido Relacionado